

本頁內容
難度
中階
所需時間
約 30–60 分鐘(含練習與自行驗證)
你需要準備
TypeSafe 官方文件
開始之前
- 能閱讀 JSON 與基本流程規則
- 先用教學或去識別資料,保留人手回退
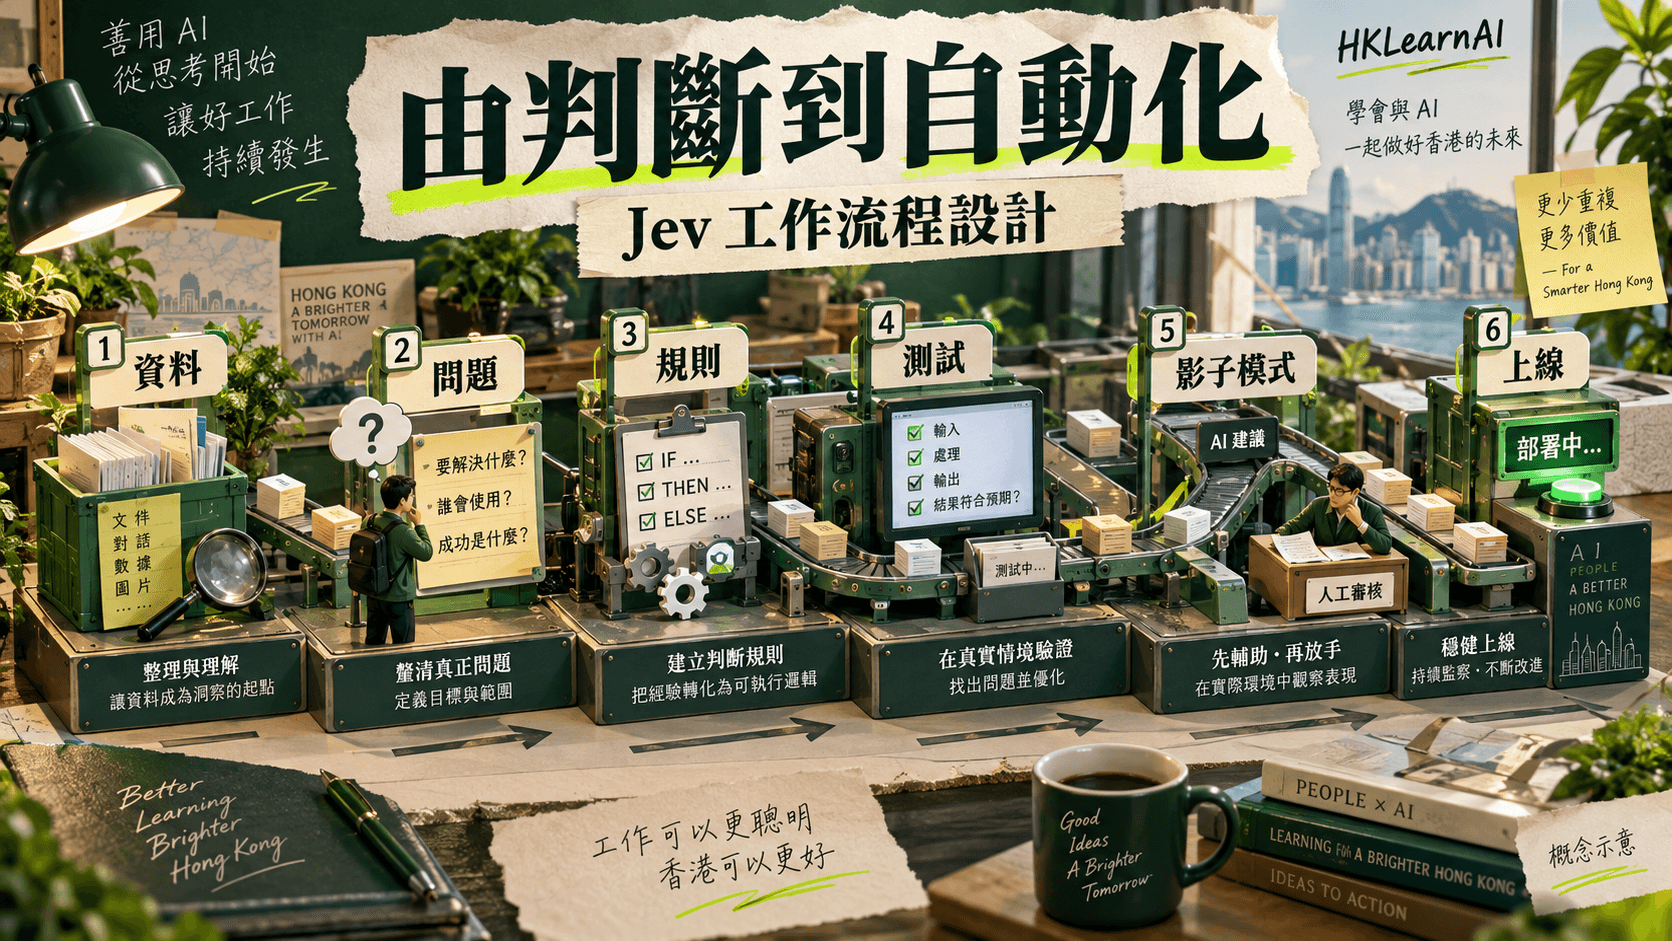
一個可用的 Jev 自動化流程,應把資料、語意問題、確定規則與行動執行分開。本篇用「把客服工單送到合適佇列」作為貫穿例子,建立由離線資料到小量上線的完整路線;產物是一份可以交給開發者實作及驗收的流程規格。
資料核對:2026 年 9 月 21 日。本文依官方文件研究;原創情境、門檻及計算例子均有標明。本站未以 Jev API 執行性能或廣東話準確率測試。模型、價格與 early access 狀態可能更新。
第一步:把目標寫成可驗收的輸出
「用 AI 自動處理客服」太大。先改成:「收到一張新工單,回傳 billing、technical、delivery 或 review 其中一個內部佇列;不向客人發送訊息,也不更改交易。」這樣,每筆結果都可以與人手分類比對,出錯也容易重新分流。
| 規格欄位 | 本篇原創示例 |
|---|---|
| 觸發 | 新工單入庫後建立唯一工作 ID。 |
| 模型可見 | 目前訊息、相關對話及必要的商品類型。 |
| 模型不可決定 | 退款金額、身份是否已驗證、帳戶角色及交易權限。 |
| 成功輸出 | 內部佇列建議、回應版本、規則版本及原因代碼。 |
| 失敗輸出 | 留在人工佇列,記錄 timeout、資料缺漏或分類低把握。 |
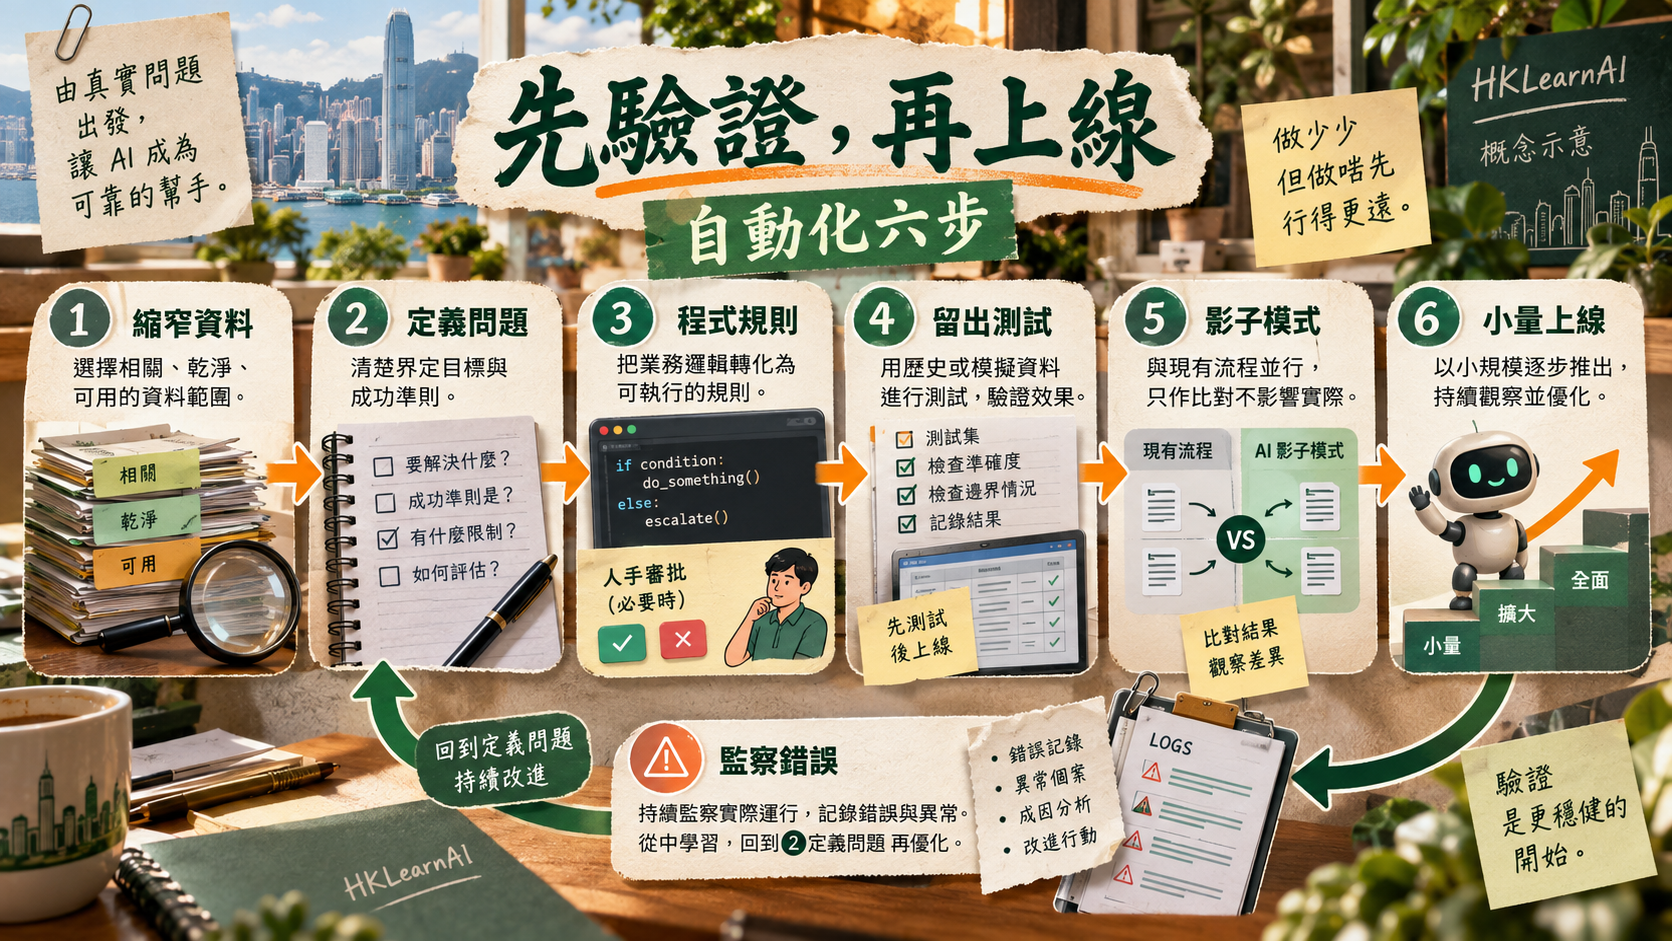
第二步:縮窄 state,保留真正影響判斷的上下文
同一張工單可能附有完整客戶紀錄,但大部分資料與意圖分類無關。建立一個明確的資料轉換層,只選入目前訊息、必要的上一輪問題及業務類型。登入狀態、角色和付款記錄由後端保留權威版本,不能相信使用者在文字裏自稱「我係管理員」。
{
  "ticket_id": "demo-001",
  "message": "未收到貨,但顯示已簽收。",
  "previous_agent_question": null,
  "product_type": "physical_goods"
}
這是資料設計示例,並非官方要求固定欄位。對話被截斷時要明確標記,不要默默移除否定句或引用上下文。測試時保留「完整上下文」和「縮窄上下文」兩種版本,觀察哪些欄位真正改善已知標籤的一致率,而不是只看信心有否上升。
核對來源:State:輸入資料結構、Jev 1.13 jaggedness — 已知能力弱點。
第三步:一題只做一個判斷
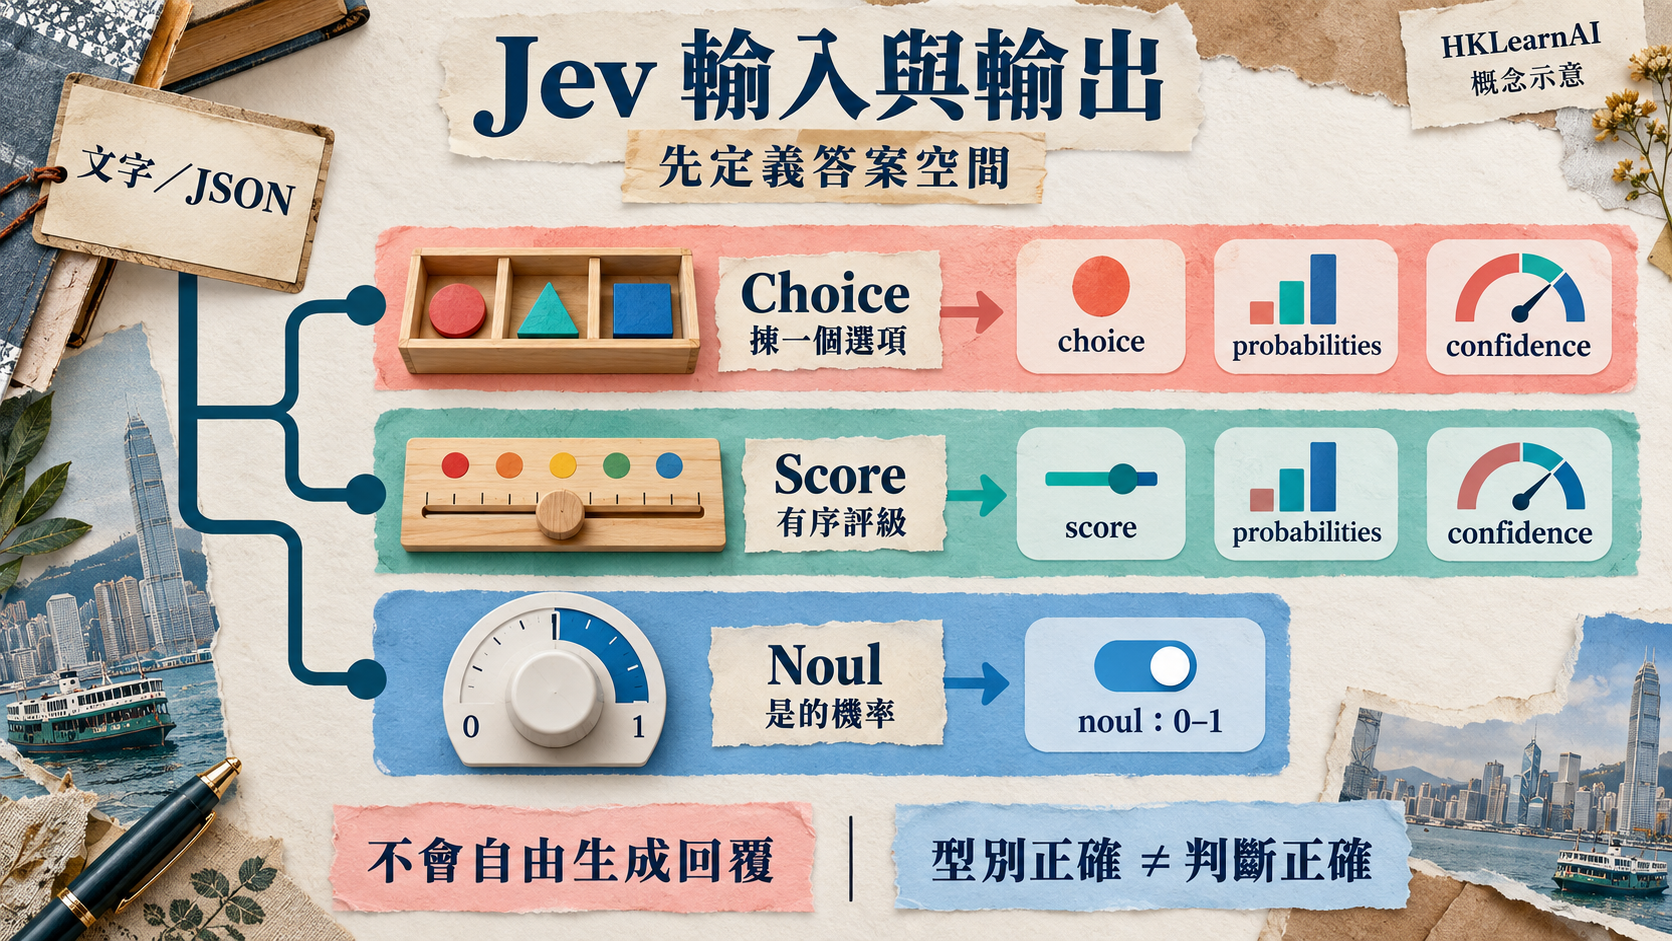
把「是否應緊急處理並退款?」拆成不同問題:主要支援類別、是否明確要求退款、是否描述時限。類別用 Choice;有沒有某項明確訊號用 Noul;有清楚等級描述的影響程度才用 Score。不要把多個否定、例外與計算塞入同一個問題。
同一個 request 的多題共用 state,並行而且互不讀取答案。如果第二題必須先知道第一題選中的候選文件,應先取得第一輪結果,再由程式準備第二輪 state。若兩題只是不同角度閱讀同一張工單,才適合一起送出。
核對來源:How to build with System One、Speculative fan-out。
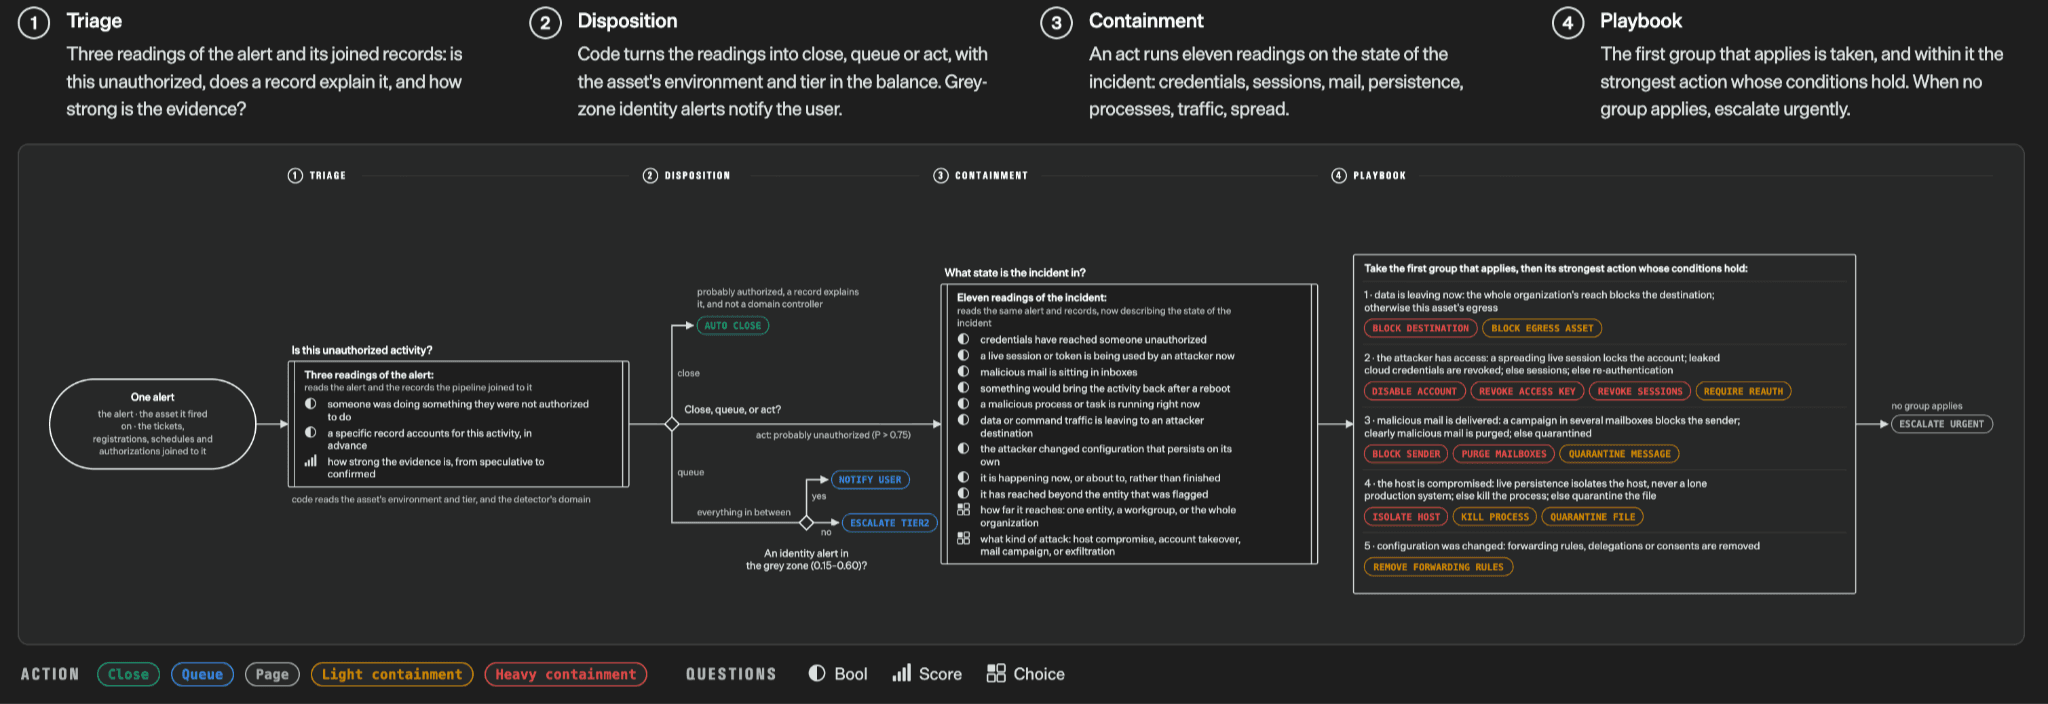
第四步:在程式中組合答案,而不是再寫一段含糊 prompt
| 情況 | 程式行為 | 要記錄的原因 |
|---|---|---|
| 必要欄位缺漏 | 送人工資料補充佇列 | missing_context |
| API timeout 或重試耗盡 | 保留工單,稍後重排或人手接管 | model_unavailable |
| 分類為 other 或未通過已驗證門檻 | 送一般人工分流 | uncertain_category |
| 類別通過門檻 | 只寫入內部分流建議 | accepted_route |
| 任何涉及退款或帳戶操作 | 另走既有身份、權限與批准流程 | action_requires_policy |
以不可變工作 ID 防止同一張工單被 webhook 重送而產生多次行動。把「模型已返回」和「業務操作已提交」分成不同狀態。這是一般工作流的可靠性設計;Jev 回覆得再快,也不會替你處理資料庫交易、重複事件或佇列恢復。
第五步:建立標籤、失敗例子及留出集
- 由不同時段與渠道抽取工單,先移除不必要的個人資料;合成例子只作補充。
- 寫一頁標註規則:主要意圖如何決定、多意圖如何處理、資訊不足如何標記。
- 把可用資料拆成設計集、門檻調整集及最後留出集;同一對話或同一客戶事件不要跨組洩漏。
- 只在設計與調整集修改 prompt、選項及門檻;最後留出集只在版本確定後評估。
- 逐類別列出錯誤、人工覆核比例及高風險漏接,不要只交一個整體準確率。
若人手也無法一致判斷某類工單,先修正分類政策。把有爭議案例交第二位標註者裁決,保留「不確定」原因。以某個大型模型產生標籤可以幫忙起草,但不能把它與 Jev 的一致率稱作人類真值準確率。
第六步:影子模式、少量流量及回退
影子模式會處理真實流入的資料並記錄建議,但現有人工流程保持決策權。你要量度的不只是 API 耗時,還包括排隊、前處理、模型呼叫、後處理與人手覆核時間。之後才把低風險且通過驗收的類別逐步交給系統分流。
- 保存 model、問題版本、規則版本、input_tokens、API 狀態、整體耗時及最終處理佇列。
- 監察各語言、渠道和商品類型的分佈;新活動可能令過往門檻失效。
- 準備一個停用自動分流的開關,切回人工並保留待處理工單。
- 升級模型或改寫 rubric 後重跑固定回歸集;不要只因 alias 名稱沒变便沿用門檻。
核對來源:Models — Jev 1.13、定價與限制、Confidence-based routing。
交付給開發者的最小文件包
交付四份資料即可開始實作:state schema 與例子、每題 instructions/criteria、答案到佇列的規則表,以及帶標籤的測試集。再附上超時與重試策略、哪些資料可以寫入日誌、回退負責人。這比一份冗長的「全能客服 prompt」更容易維護。
對照官方工作流:哪些判斷交模型,哪些規則交程式?
資料處理條款亦要分清:官方說請求與回應不作模型訓練,但「不訓練」不是「所有方案不保留」。按實際帳戶條款核對保留安排;官方另列企業 ZDR 選項。
核對來源:Legal:資料處理及保留政策入口。
下一步閱讀
資料來源與引用
我們附上第一手及官方來源,方便你逐一核實。
- 1.State:輸入資料結構 — TypeSafe AI
- 2.How to build with System One — TypeSafe AI
- 3.Speculative fan-out — TypeSafe AI
- 4.Jev 1.13 jaggedness — 已知能力弱點 — TypeSafe AI
- 5.Models — Jev 1.13、定價與限制 — TypeSafe AI
- 6.Confidence-based routing — TypeSafe AI
- 7.Legal:資料處理及保留政策入口 — TypeSafe AI
- 8.Introducing System One Models & Jev — TypeSafe AI
常見問題
同一次 Jev 請求的問題可以互相讀答案嗎?
不可以。多題共用 state 但獨立判斷,有依賴的步驟要由程式分階段呼叫。
第一次試點應自動回覆客人嗎?
本篇建議先做內部分流並以影子模式比較;是否自動回覆須另行驗證內容品質及政策。
本文遵循我們的 編輯準則.
關於作者
HK Learn AI 編輯部
HK Learn AI 編輯部負責研究、查證同編寫每一篇內容,並引用官方及第一手來源。
此主題相關文章
Jev vs LLM 點分工?程式、決策模型與生成模型的混合架構指南
比較 Jev、LLM 與普通程式的責任:客服分類、RAG 段落選擇、候選值抽取、草稿生成與權限驗證,附分階段呼叫及失敗回退設計。
Jev 廣東話客服分流教學:否定句、中英夾雜、付款與物流意圖測試
用十二句原創廣東話客服測試設計 Jev 分流,處理否定、引述、中英夾雜及多意圖;把付款分類與退款授權分開,附可用 request 與驗收方法。

2026 還值得學 n8n 嗎?自動化工具定位、適用場景與 Inbox Triage 工作流
n8n 沒有被 AI Agent 取代,但亦不應成為每個任務的預設答案。本文以 2026 年產品、價格和授權資料,拆解何時用固定 workflow、何時加入模型、何時改用程式;再逐步重建 Gmail → 資料整理 → Sheets 查價 → AI 草稿 → 人工批准 → 回覆的 inbox triage 流程,補上資料契約、冪等、監控、安全與驗收清單。