

本頁內容
Jev 的低價與高速值得測試,但首頁倍數不能直接代入你的業務。TypeSafe 將 193.6 倍速度、444.6 倍成本優勢連結至自家工作流評估;本篇把測試方法、模型卡價格與自己的估算分開,讓你能設計公平的概念驗證。
資料核對:2026 年 9 月 21 日。本文依官方文件研究;原創情境、門檻及計算例子均有標明。本站未以 Jev API 執行性能或廣東話準確率測試。模型、價格與 early access 狀態可能更新。
先讀懂官方圖:橫軸便宜,縱軸究竟是甚麼?
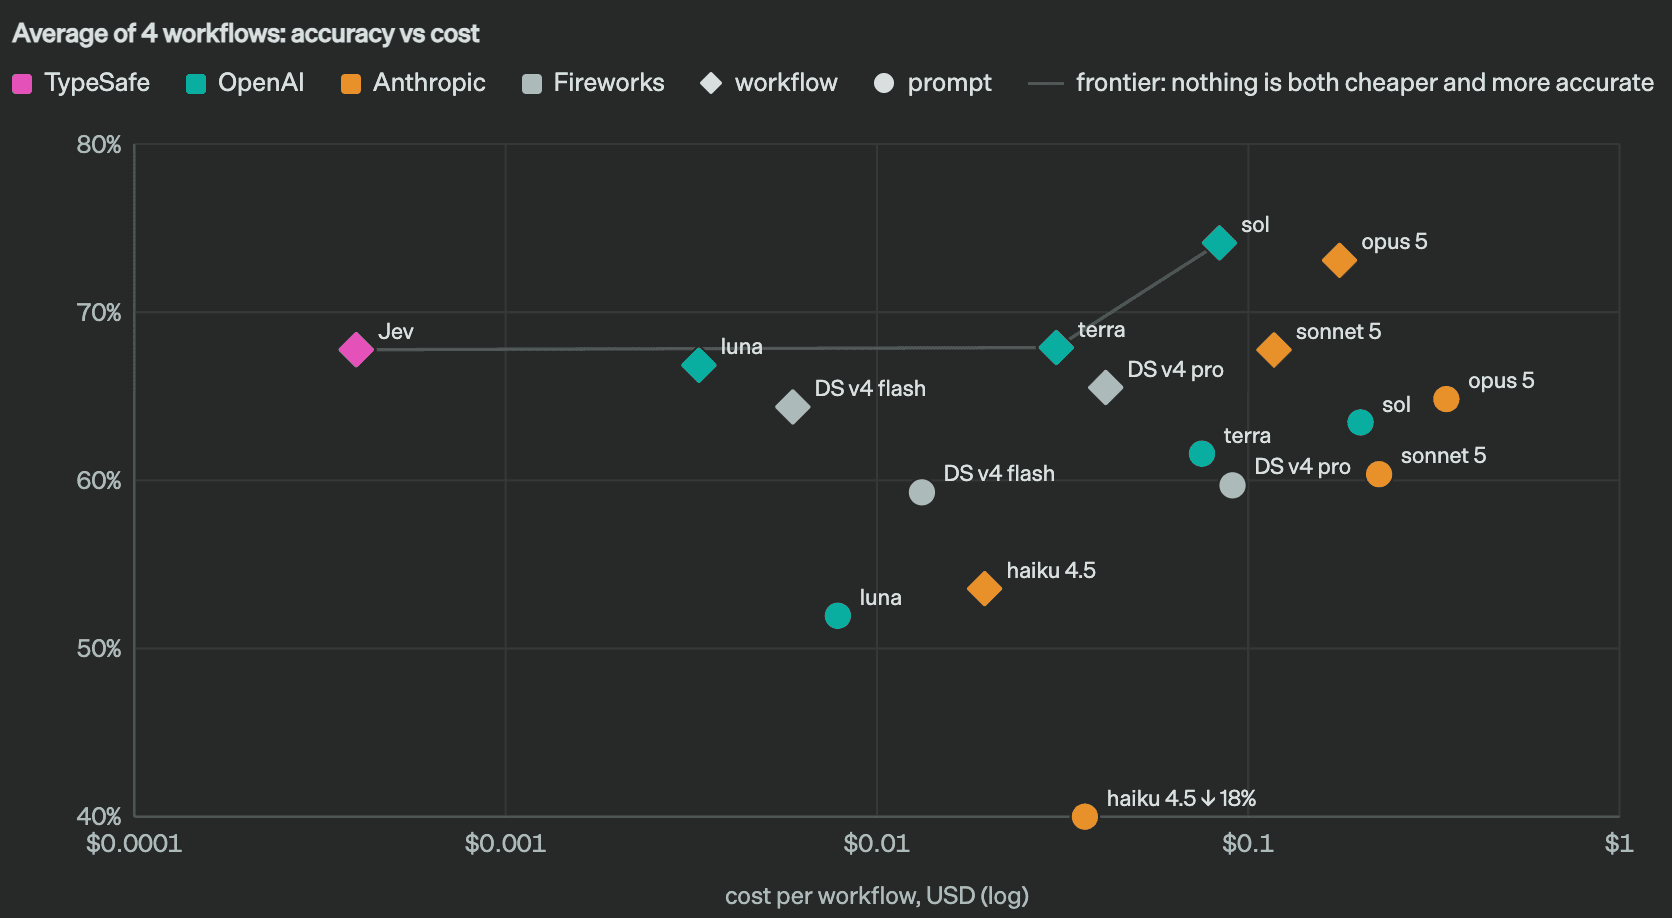
這幅圖適合用來提出下一輪測試問題,不適合直接宣布通用模型排名。相同點在不同任務組合或不同推理設定下可能移動。讀圖時先記下來源、核對日期和模型配置,再查看它真正比較的是完整工作流、單一 prompt,還是純粹一次模型回應。
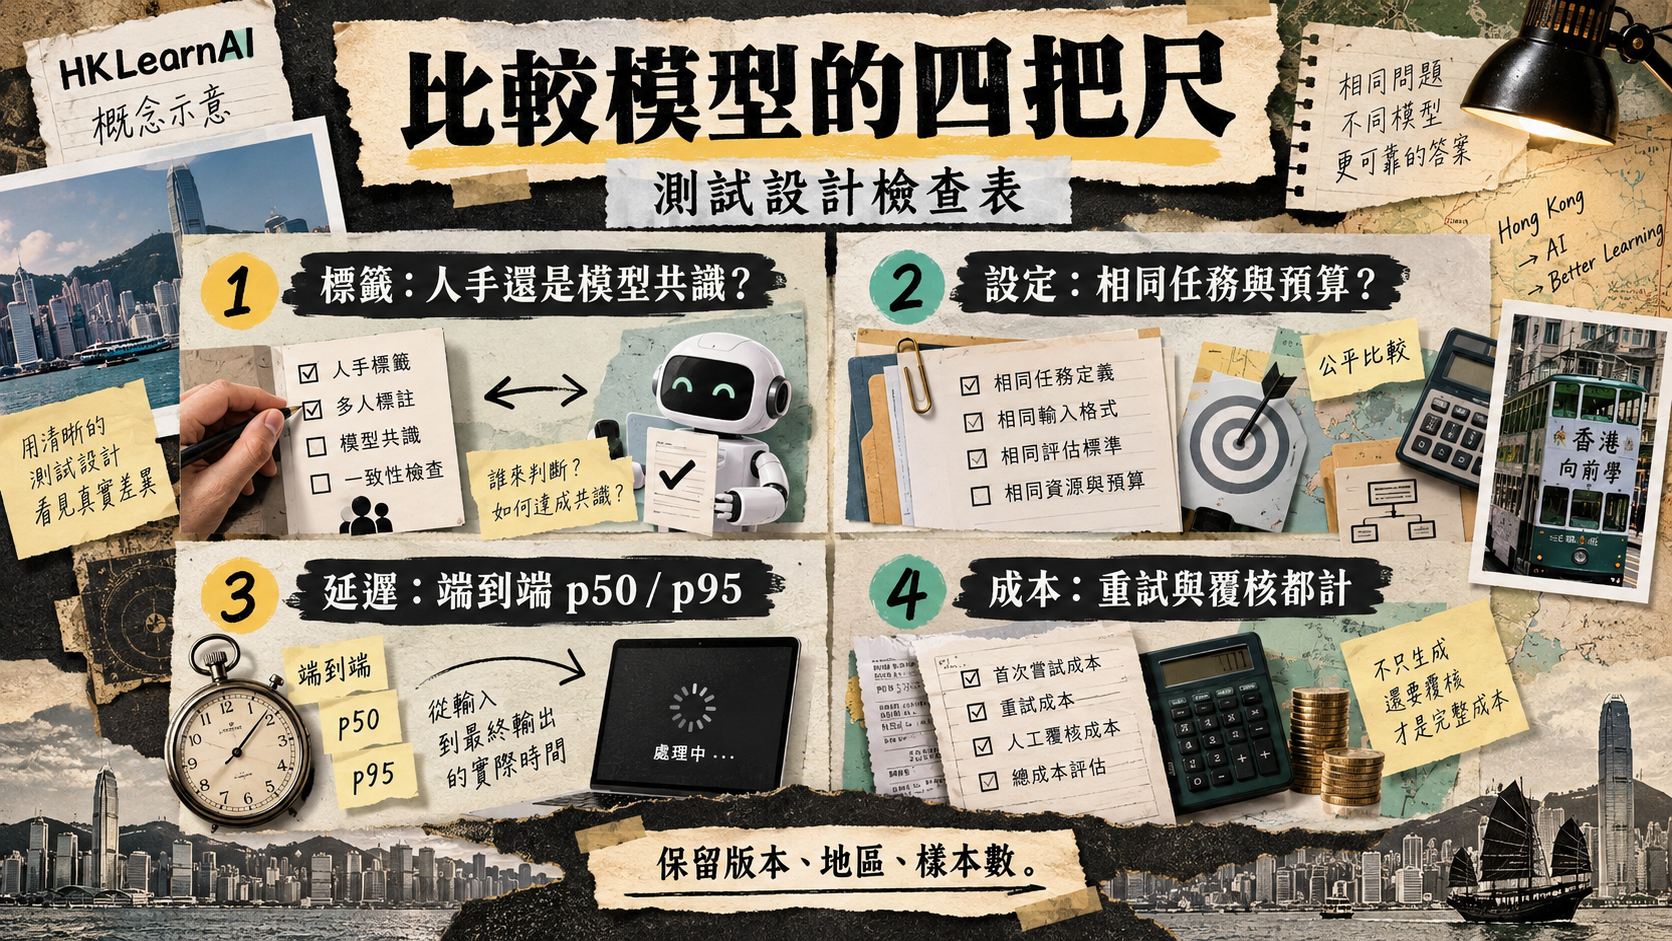
這組評估的標籤、任務及比較方式
| 項目 | 官方披露 | 對解讀的影響 |
|---|---|---|
| 任務 | 安全事件、agent trace、發票處理、客服四個工作流 | 不代表所有行業、語言或生成任務。 |
| 彙總 | 四個工作流等權平均 | 你的流量比例不同,整體收益也可能不同。 |
| 參考標籤 | GPT-6 Astra 與 Claude Fable 5.1 高 thinking 回答的平均 | 測量與模型共識的吻合,不是人手真值。 |
| 執行條件 | 比較模型採供應端預設 reasoning 設定 | 不能當作每個模型都已調到相同延遲或成本預算。 |
| 輸出介面 | LLM adapter 要求相容的結構化決策與機率 | 需同時看這種介面的開銷及你的實際需求。 |
核對來源:Workflow evals — 方法與四個工作流、System One LLM adapter 原始碼。
官方也承認發布倍數可能接近真實收益的較高端。因此,本篇不把 193.6 或 444.6 當作保證節省比例,也不把圖中的型別錯誤率解讀成語意錯誤率。對香港讀者,網絡路徑和現有系統的排隊時間仍是未量度的變數。
核對來源:Introducing System One Models & Jev。
影片導讀:官方並排 API 示範(Vimeo)
觀察同一段資料如何轉成多個結構化判斷。這是供應商示範,輸入刻意短而密集,不能代表香港網絡延遲或所有任務。
影片及示範由 TypeSafe 製作;原文與方法限制。
模型卡價格:US$0.042/百萬輸入 tokens
截至 2026-09-21,Jev 1.13 模型卡列出輸入 US$0.042/百萬 tokens,輸出免費。下面只計模型輸入費,用假設每個工作流的總輸入 token 用量作算術示例,並非實測帳單。
| 假設每個工作流輸入 | 10 萬個工作流的總 tokens | 按現價估算模型輸入費 |
|---|---|---|
| 1,000 tokens | 100,000,000 | US$4.20 |
| 5,000 tokens | 500,000,000 | US$21.00 |
| 20,000 tokens | 2,000,000,000 | US$84.00 |
模型輸入費 = 工作流數 × 每個工作流總 input_tokens ÷ 1,000,000 × 0.042「每個工作流總輸入」必須包括所有成功呼叫、重試及分階段請求的實際用量。多題共用 state 可減少重送資料,但多次呼叫仍可能重複計入上下文。更完整的預算還包括 OCR、LLM 草稿、資料庫、佇列、監察及人工覆核;模型單價低,不代表整個服務成本接近零。
核對來源:Models — Jev 1.13、定價與限制、Speculative fan-out。
速率與 context 有兩種不同限制
| 欄位 | 2026-09-21 模型卡所列 | 實作提醒 |
|---|---|---|
| 模型 ID | jev-1.13.0 | 保存實際回應版本,別名可更新。 |
| 請求速率 | 1,200 requests/minute | 屬 early access 可調整限制,不是固定合約承諾。 |
| token 速率 | 250,000 tokens/second | 請求數未達上限,也可能先撞 token 限制。 |
| 整個請求預算 | state+所有問題合計 64k tokens | 大量問題不是無限制。 |
| 單題上下文預算 | state+最長單題 32k tokens | 不能用「64k」推論單一長問題也可用 64k。 |
核對來源:Models — Jev 1.13、定價與限制。
若每分鐘 1,200 次均勻發送,相當於平均每秒 20 次;這只是算術換算,並不代表供應商允許任意 burst。測試並行量時應觀察 429、529、Retry-After 與尾部延遲,而不是只把工作開到最大。
自己做比較:固定任務,另外測最佳實用方案
- 先建立有人手標籤且與未來流量相似的留出集,包括繁體、廣東話及中英夾雜。
- 第一輪固定相同工作流、問題與輸出需求,用來比較模型差異。
- 第二輪讓各方案採合理的最佳實作,例如程式規則、LLM 結構化輸出或 Jev 分題;比較整體產品收益。
- 從實際部署地區量度端到端 p50、p95、失敗率與重試量;標明是否 warm run 及並行數。
- 報告各類別錯誤、接受個案錯誤率、人工覆核比例與每件完成工作的成本。
- 保存模型 ID、時間、樣本數、prompt/rubric、推理設定與程式版本,讓別人能重做。
甚麼結果才足以繼續投資?
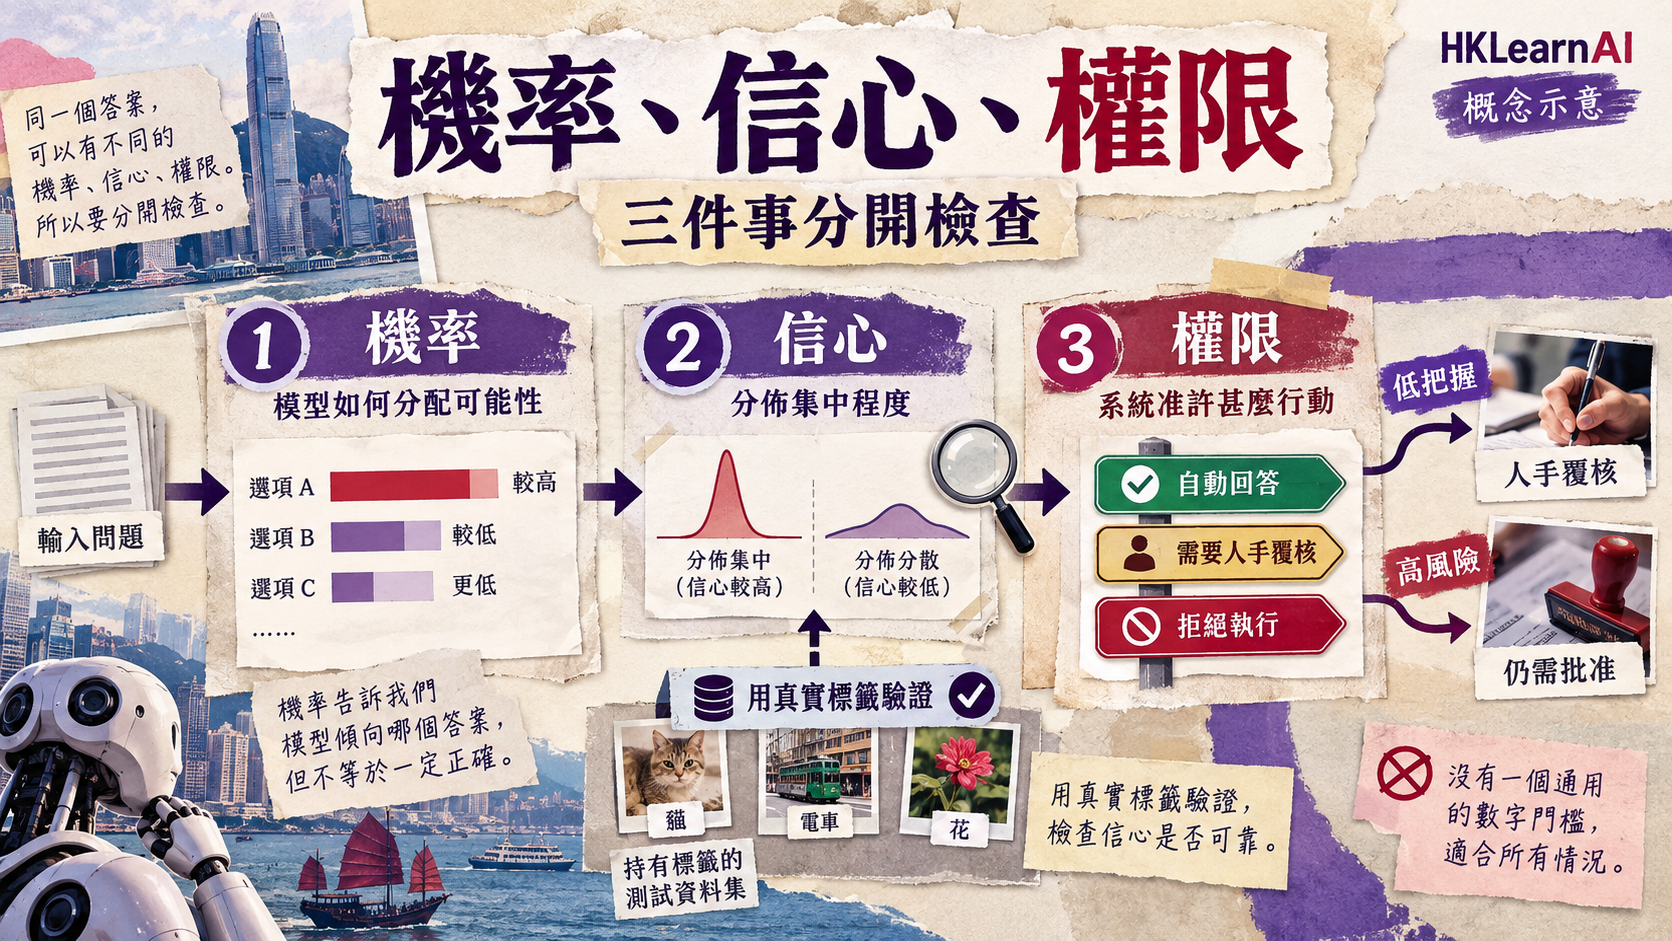
先訂最低可接受品質與覆核量,再比較成本和延遲。若某方案便宜十倍但令人工佇列塞滿,收益未必成立;若規則本來已能精確解決問題,新增模型也未必有必要。本次研究沒有取得可重現的本站 Jev 實測數據,因此不提供香港延遲、廣東話準確率或實際節省比例。
下一步閱讀
資料來源與引用
我們附上第一手及官方來源,方便你逐一核實。
常見問題
Jev 真係平 444.6 倍嗎?
這是 TypeSafe 特定工作流評估的官方宣稱,不能直接推算到你的任務、地區和覆核成本。
Jev 現價是多少?
截至 2026-09-21,模型卡列輸入 US$0.042/百萬 tokens、輸出免費;實際使用前需再核對。
官方 accuracy 是人手標籤準確率嗎?
該工作流評估使用大型模型回答平均作參考標籤,不能等同人手真值。
本文遵循我們的 編輯準則.
關於作者
HK Learn AI 編輯部
HK Learn AI 編輯部負責研究、查證同編寫每一篇內容,並引用官方及第一手來源。
此主題相關文章
Jev confidence 教學:分清機率、校準與門檻,設計人手覆核
用留出資料校準 Jev 門檻:分清 probability、confidence、真實標籤、Brier score、coverage 與接受個案錯誤率,附標明非實測的計算例子。
ChatGPT 做 Excel 財務模型教學:現金流預測、情境分析同公式核對
用一間虛構的香港小型網店做例子,分兩條路線用 ChatGPT 建立 12 個月現金流模型:對話上傳 Excel 用資料分析起草,或用官方 ChatGPT for Excel 增益集直接改工作簿;再用 Excel 內建 What-If 工具做 base、upside、downside 三個情境,最後核對 NPV、IRR 公式。不是投資或稅務意見;資料核對 2026 年 9 月 15 日。

ChatGPT Visualize 完整教學:把 CSV/資料集變成可篩選互動圖表與下鑽分析
以 1949–1960 航空旅客月度資料示範 Visualize:確認帳戶可用性、用 @Visualize 選取 plugin、描述資料與問題、建立年份/月份篩選、摘要卡、趨勢線和可點選明細,再核對筆數、缺失值、單位、合計與極值。附逐張人工審核的去識別畫面、3 段預覽、提示公式與 QA 清單。