

本頁內容
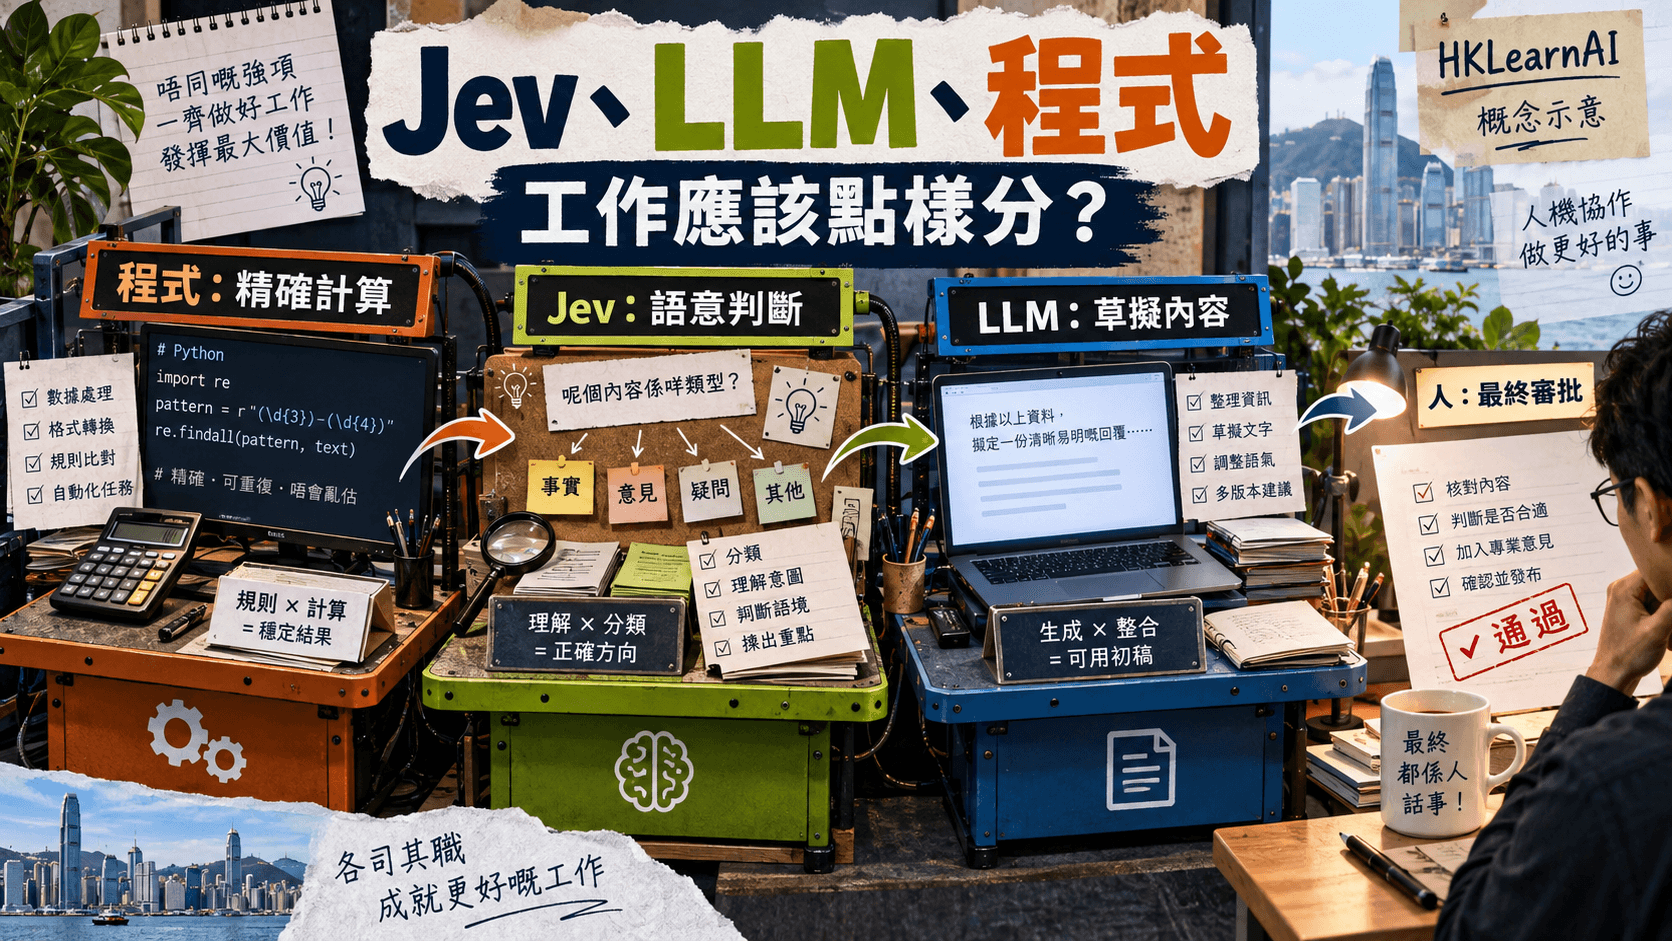
Jev 適合有明確答案空間的語意判斷;LLM 適合產生草稿與解說;精確計算和權限則交普通程式。評估是否加入 Jev,應看系統中有哪些反覆發生的分類、評級及相關性判斷,而不是把整個聊天助手換成另一個模型。
資料核對:2026 年 9 月 21 日。本文依官方文件研究;原創情境、門檻及計算例子均有標明。本站未以 Jev API 執行性能或廣東話準確率測試。模型、價格與 early access 狀態可能更新。
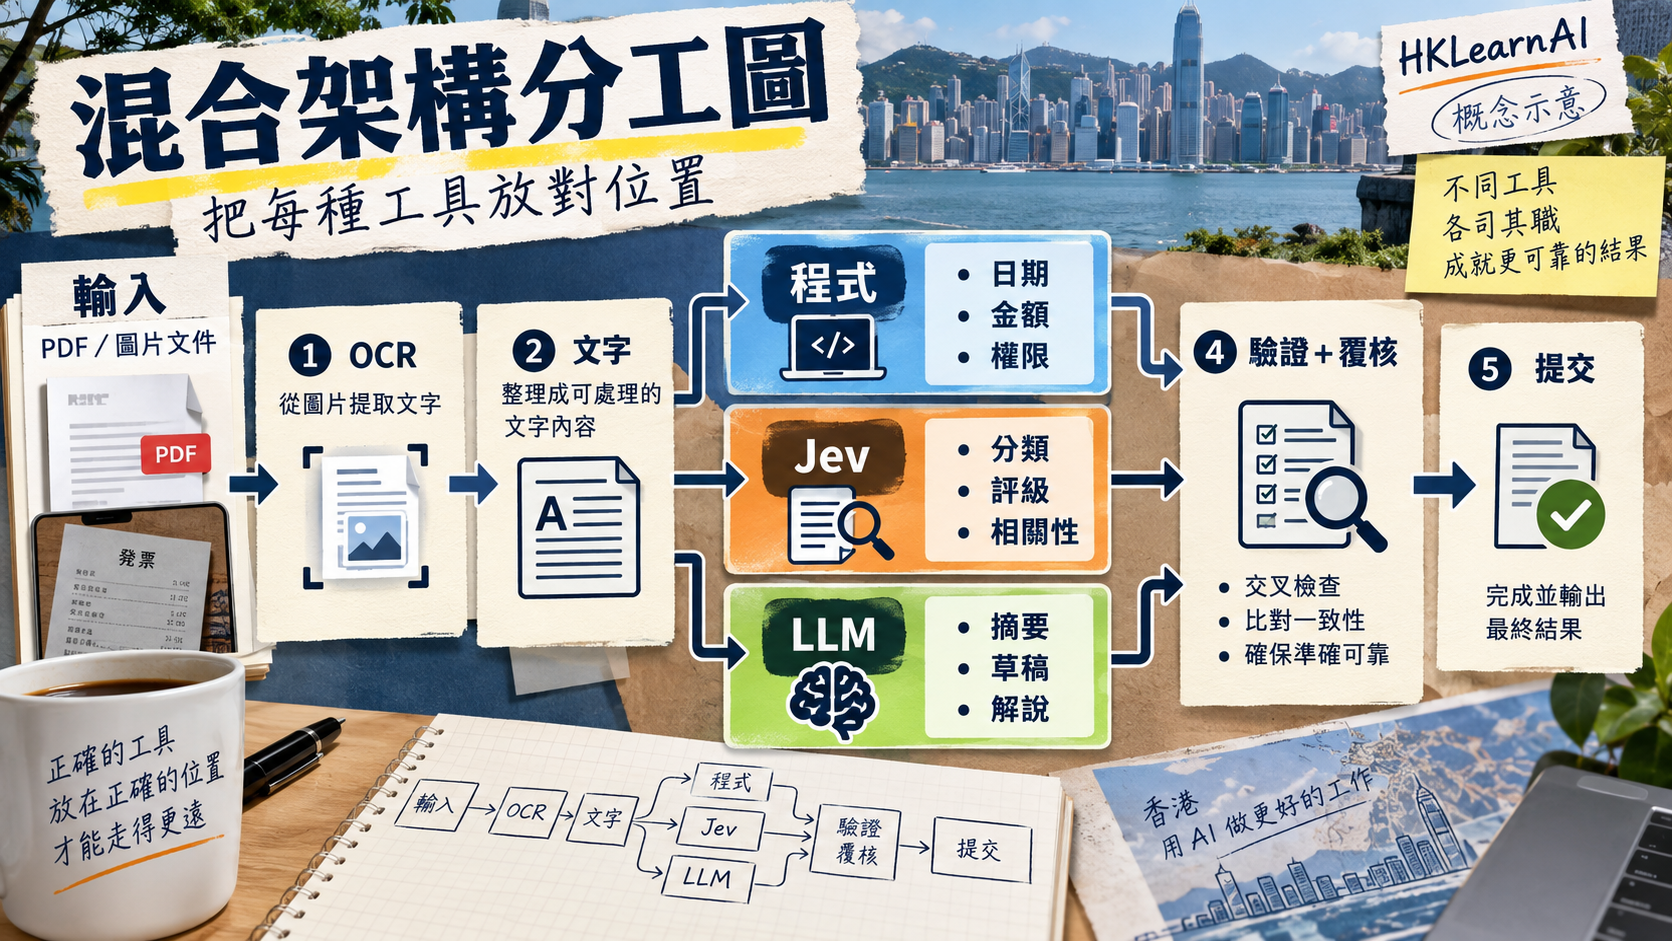
用輸出需求決定工具,而不是只看模型名氣
| 工作 | 優先考慮 | 原因與邊界 |
|---|---|---|
| 訂單是否超過七日、退款上限 | 程式+權威資料庫 | 日期與金額可精確運算,身份與權限不應由文字推斷。 |
| 工單屬於付款還是物流 | Jev 或其他經驗證分類器 | 答案空間清楚,可用標籤測試。 |
| 按 rubric 評估段落是否相關 | Jev 等決策模型 | 判斷輸入與問題關係,但不是證明資料真確。 |
| 寫一封自然的廣東話回覆 | LLM | 需要自由文字;仍要依資料與政策覆核。 |
| 抽取圖片或掃描 PDF 文字 | OCR/視覺工具 | Jev 模型卡列為文字輸入,先做前處理。 |
| 核對字串是否在候選清單 | 程式 | 既然可以精確查表,毋須增加模型不確定性。 |
核對來源:Models — Jev 1.13、定價與限制、Jev 1.13 jaggedness — 已知能力弱點。
LLM 也可做結構化決策,比較要公平
不能把 LLM 描述成永遠只能輸出散文,再以此證明 Jev 勝出。TypeSafe 自己的公開評估就使用 adapter,讓其他模型回傳相容的結構化決策及機率。真正需要比較的是:你的輸出限制、品質門檻、延遲和成本,在不同實作下能否達成。
可設兩輪實驗:先固定同一工作流和輸出要求,比較模型;再讓每個方案採合理的實作,比較完整產品。第一輪回答「模型替換有何差異」,第二輪回答「用哪種系統最划算」。不要混合兩輪數字,再把差距全歸因於單一模型。
核對來源:System One LLM adapter 原始碼、Workflow evals — 方法與四個工作流。
RAG 範例:先找候選,再判斷相關,最後寫答案
- 搜尋層從知識庫取回候選段落,附上穩定的文件 ID、版本及來源連結。
- 把使用者問題與每個候選段落組成可檢查的 state,判斷是否真正回答問題。
- 由程式選擇保留的段落;若全部不足,走補充搜尋或明確告知資訊不足。
- LLM 根據保留原文草擬回答,要求引用原有文件 ID。
- 程式確認引用 ID 存在,並把答案與來源交覆核或後續檢查。
這裏有三種不同檢查:段落相關、答案有否被段落支持、段落本身是否可信。第一種通過不代表後兩種通過。即使再用 Jev 做 citation check,它仍是一個可能出錯的語意判斷,不能把同一段錯誤來源變成真實證據。
核對來源:Classifying RAG passages、Citation check cookbook。
抽取資料時,先建立候選值
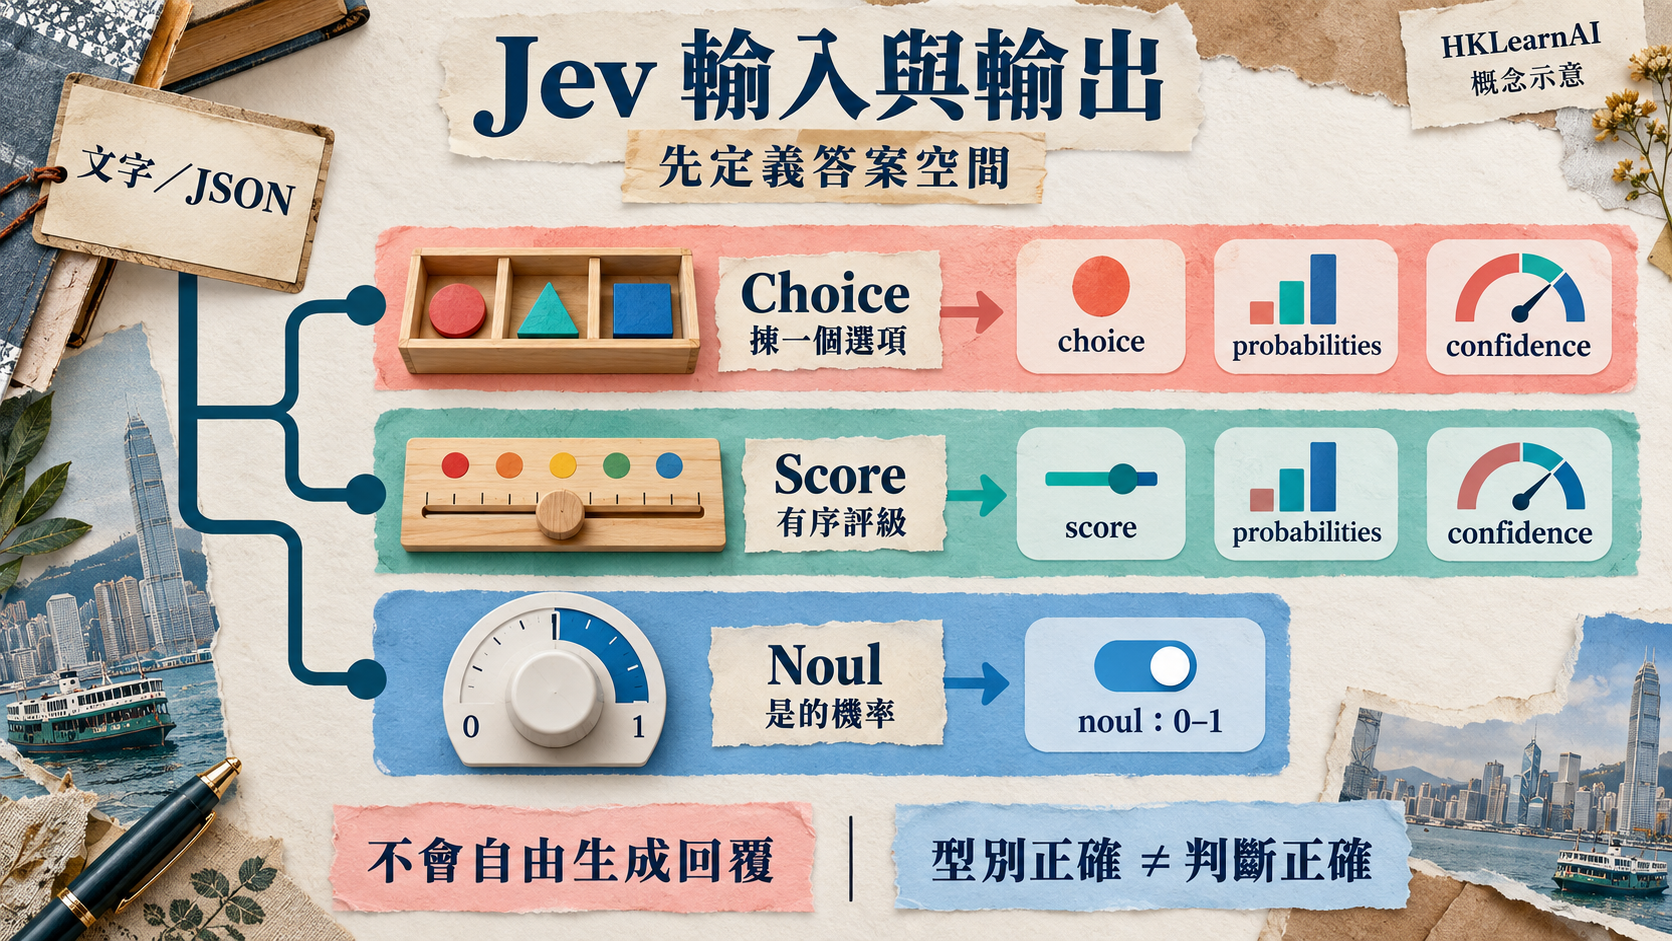
Jev 不自由生成字串,因此「請輸出這張單的發票號碼」不是直接套用聊天抽取的方式。可以先用 regex、OCR 或其他工具找出候選值,保留它們的原文位置,再讓 Choice 從候選中選合適的一個。若候選本身漏了正確值,模型再好也無法選中。
例如文件含訂單號、發票號和物流號,先保留各字串及周邊標籤,模型只判斷哪個符合「發票號」的語意。金額加總、日期格式和校驗碼仍由程式計算。這樣每一層的錯誤可分開量度:候選召回不足、候選選錯,還是後續格式驗證失敗。
核對來源:Pre-parsed value extraction。
並行與分階段:省一次呼叫,可能增加多少工作?
若所有候選都能獨立評估,可以一次送入多題;如果後一步必須讀到前一步選中的內容,則要兩階段。Choice 的選項上限亦意味着大量候選可能需要先篩再選。拆分帶來額外呼叫,但也讓每一步有清楚的資料範圍。
估算時把各分支觸發率寫下來。例如只有少數工單需要 LLM 草稿,就先分類再決定是否生成;如果大多數都需要,過度拆分可能只增加網絡往返。應以整條流程的 p95 和每件完成工作的總成本比較,不能只比較單次 API 的平均延遲。
核對來源:Speculative fan-out、Choice primitive。
觀察從既有連結中選下一步。候選過多時還有分階段篩選;這不是無限制的自由生成或通用能力排名。
影片及示範由 TypeSafe 製作;原文與方法限制。
為每一層寫出失敗時的行為
| 失敗層 | 應保留的資訊 | 合理回退 |
|---|---|---|
| OCR 或候選抽取 | 原文件位置、抽取錯誤 | 要求更清晰文件或人工補錄。 |
| Jev 分類/相關性 | 版本、題目、答案與不確定原因 | 人工選擇或補充資料。 |
| LLM 草稿 | 採用的來源 ID、草稿版本 | 不自動送出,要求覆核。 |
| 業務規則或權限 | 明確拒絕代碼、事件 ID | 停止操作,不能用另一個模型繞過。 |
| 供應商 timeout | 工作狀態及重試次數 | 佇列重排、保留原流程。 |
甚麼情況未必要加入 Jev?
如果量很小、人手覆核本來就必要,新增服務的維護成本可能比模型費更大。若判斷完全可以用確定規則處理,先用程式。若需求主要是長文生成,先改善來源和評估方法。只有在大量可界定的語意判斷成為成本或延遲瓶頸時,Jev 才是一個值得做獨立試點的候選。
下一步閱讀
資料來源與引用
我們附上第一手及官方來源,方便你逐一核實。
- 1.Models — Jev 1.13、定價與限制 — TypeSafe AI
- 2.Jev 1.13 jaggedness — 已知能力弱點 — TypeSafe AI
- 3.System One LLM adapter 原始碼 — TypeSafe AI / GitHub
- 4.Workflow evals — 方法與四個工作流 — TypeSafe AI
- 5.Classifying RAG passages — TypeSafe AI
- 6.Citation check cookbook — TypeSafe AI
- 7.Pre-parsed value extraction — TypeSafe AI
- 8.Speculative fan-out — TypeSafe AI
- 9.Choice primitive — TypeSafe AI
常見問題
Jev 可以取代所有 LLM 嗎?
不可以。自由文字生成等需求仍需其他工具;Jev 的定位是有限答案空間的語意判斷。
Jev 做 citation check 就保證答案真確嗎?
不保證。引用 ID 存在、段落支持答案及來源本身可信是不同檢查,語意模型仍可能出錯。
本文遵循我們的 編輯準則.
關於作者
HK Learn AI 編輯部
HK Learn AI 編輯部負責研究、查證同編寫每一篇內容,並引用官方及第一手來源。
此主題相關文章
Jev 廣東話客服分流教學:否定句、中英夾雜、付款與物流意圖測試
用十二句原創廣東話客服測試設計 Jev 分流,處理否定、引述、中英夾雜及多意圖;把付款分類與退款授權分開,附可用 request 與驗收方法。
Jev AI 自動化完整教學:由 state、問題設計到測試與上線
把 Jev 接入可驗收的工作流:定義 state、拆解原子問題、程式規則、留出集、影子模式與回退,附香港客服規格和交付清單。

2026 還值得學 n8n 嗎?自動化工具定位、適用場景與 Inbox Triage 工作流
n8n 沒有被 AI Agent 取代,但亦不應成為每個任務的預設答案。本文以 2026 年產品、價格和授權資料,拆解何時用固定 workflow、何時加入模型、何時改用程式;再逐步重建 Gmail → 資料整理 → Sheets 查價 → AI 草稿 → 人工批准 → 回覆的 inbox triage 流程,補上資料契約、冪等、監控、安全與驗收清單。